DoE-Happen #69 – Was in DoE-Kursen zu kurz kommt?
Und warum sich ein Blick in die codierte Matrix trotzdem lohnt!
Länger sind meine Kurse nicht geworden. Wohl aber hat sich verschoben, was in den Kursen erlernt wird. PAR- und NOR-Plots, Toleranzauslegung, Zielwertoptimierung mit Monte-Carlo-Simulation oder Simplex, Verteilungsannahmen für Vorhersagen: All das nimmt heute mehr Raum ein als früher – weil die DoE-Software selbst umfangreicher geworden ist. Ein Treiber dafür sind regulatorische Anforderungen wie die ICH-Guidelines Q8 bis Q12 in der Pharmaentwicklung, die genau solche Auswertungen (Design Space, Risikobewertung, Lifecycle-Management) explizit einfordern – Daraufhin haben Softwarehersteller nachgezogen oder teilweise vorgelegt, und die Kursinhalte damit auch. Was dabei zwangsläufig zu kurz kommt: Der Kern der Versuchsplanung die Herleitung der Regression selbst. Und das ist auch in Ordnung, denn kein Teilnehmer rechnet diese Matrix von Hand. Die Software übernimmt das.
Trotzdem lohnt sich ein Blick unter die Haube. Einmal, an einem kleinen Beispiel.
Ich selbst bringe es in meinen Kursen auf den Punkt: „Sie müssen die Matrix nicht rechnen können. Sie müssen wissen, was die Software Ihnen zeigt.“ Und das stimmt auch. Aber genau dieses Wissen entsteht am besten dort, wo man es einmal selbst durchgerechnet hat.
Im Kurs selbst überfordert die schiere Menge an neuen Optionen und das veränderte Denken – weg vom OFAT, hin zu DoE – ohnehin schon genug. Doch sobald der „Freischwimmer“ geschafft ist, wollen gerade erfahrene Anwender genau das wissen: Woraus leitet die Software ihre Entscheidungen ab? Nicht aus Neugier allein, sondern weil sie diese Entscheidungen im eigenen Projekt auch vertreten müssen.
Aus diesem Grund möchte ich hier einen Punkt aus den Grundlagen einmal darstellen. Vorher aber ein Hinweis: Dafür muss ich die ein oder andere Formel bemühen.
Stephen Hawking schreibt in seinem Buch, ihm sei gesagt worden, „each equation I included in the book would halve the sales“ – jede Formel halbiere die Leserschaft. Ich halte mich heute bewusst nicht daran: Dieser Artikel braucht ein paar Formeln mehr als sonst.
Die eine Formel, um die es geht
Im Zentrum steht ein einfaches lineares Modell für zwei Faktoren mit einer Wechselwirkung:
y = b₀ + m₁·x₁ + m₂·x₂ + m₁₂·x₁·x₂
x₁ und x₂ sind die codierten Faktoreinstellungen (−1 / +1), b₀ die Konstante (Achsenabschnitt), m₁ und m₂ die Haupteffekt-Koeffizienten, m₁₂ der Koeffizient der Wechselwirkung. Mehr braucht dieser Artikel an Formeln nicht – der Rest ist Rechnung mit Zahlen, keine neue Theorie.
Warum ein 2²-Design mit Center Points
Bei nur zwei Faktoren muss man nicht screenen. Ein volles 2²-Design – vier Eckversuche plus Center Points – deckt bereits beide Haupteffekte und die Wechselwirkung vollständig ab, ohne Vermengung. Erst bei mehr als 4 Faktoren wird ein teilfraktionierter Plan interessant, weil die Anzahl der Versuche sonst explodiert (dazu mehr in [INTERN-LINK: Blog zu teilfraktionierten Designs, #63]).
Unser Beispiel: eine Klebstoffmischung, deren Viskosität von Temperatur und Rührgeschwindigkeit abhängt.
- x₁ – Temperatur: 60 °C (−1) / 80 °C (+1)
- x₂ – Rührgeschwindigkeit: 600 U/min (−1) / 1.000 U/min (+1)
- y – Viskosität in Pa·s
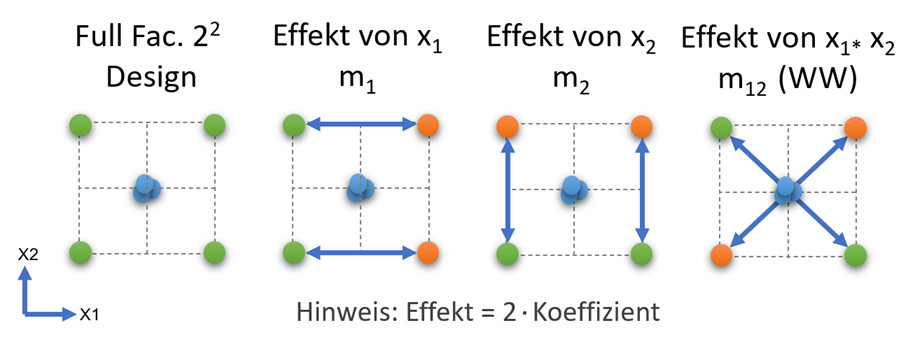
Abbildung 1: Im 2²-Design mit Center Points lassen sich Haupteffekte und Wechselwirkung getrennt ablesen – x₁ horizontal, x₂ vertikal, die Wechselwirkung x₁·x₂ diagonal über das Schachbrettmuster der Eckpunkte. Wichtig dabei: Die Pfeile zeigen den vollen Sprung von niedriger zu hoher Einstellung – also den Effekt. Der Koeffizient (m₁, m₂, m₁₂), den wir gleich aus der Matrix berechnen, ist genau die Hälfte davon: Effekt = 2 · Koeffizient.
Die codierte und die unkodierte Matrix nebeneinander
Jede Zeile im Versuchsplan wird zu einer Zeile in der Design-Matrix X. Codiert und unkodiert sehen die Spalten für Konstante, x₁, x₂ und x₁·x₂ so aus:
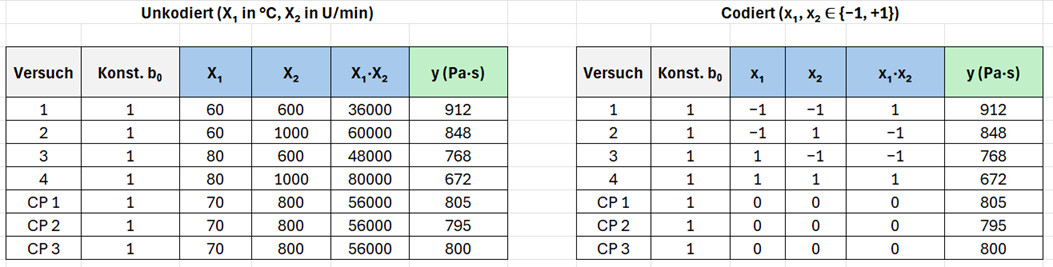
Abbildung 2: Die Design-Matrix nebeneinander – links mit den tatsächlichen Einstellungen (Temperatur in °C, Rührgeschwindigkeit in U/min), rechts codiert auf −1/+1. Die Center-Points (CP) liegen codiert exakt bei (0, 0, 0) – das wird im nächsten Abschnitt wichtig.
Die Codierung ist mehr als eine Rechenhilfe. Temperatur (°C) und Rührgeschwindigkeit (U/min) bewegen sich in völlig unterschiedlichen Zahlenbereichen – ein direkter Vergleich wäre Äpfel gegen Birnen. Codierung skaliert beide Faktoren auf dieselbe Spanne (−1 bis +1) und macht sie dadurch vergleichbar. Erst dadurch lassen sich auch die Koeffizienten und Effekte der Faktoren – und der Wechselwirkung – überhaupt sinnvoll miteinander vergleichen, so wie wir es weiter unten mit m₁, m₂ und m₁₂ tun werden.
Schon hier fällt zudem etwas auf: In der unkodierten Spalte X₁·X₂ stehen fünfstellige Zahlen, während x₁·x₂ codiert nur −1, 0 oder +1 kennt. Das ist kein Zufall – und wird gleich wichtig.
Orthogonalität: Warum das Design die Rechnung einfach macht
Für die Koeffizientenberechnung braucht man X’X – die transponierte Matrix X‘, multipliziert mit X selbst. Der Zwischenschritt macht das nachvollziehbar: X‘ entsteht, indem man die Design-Matrix X (7 Versuche × 4 Spalten) kippt – aus den vier Spalten werden vier Zeilen, aus den sieben Zeilen werden sieben Spalten. Multipliziert man X‘ anschließend mit X, ergibt sich die codierte Matrix X’X:
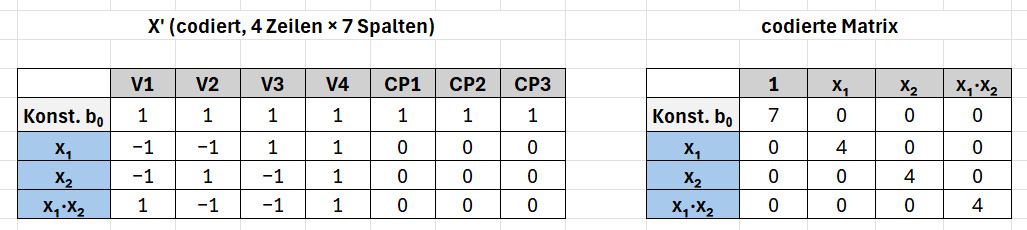
Abbildung 3: Links die transponierte Matrix X‘ (4 Zeilen × 7 Spalten), rechts das Ergebnis X’X. Auffällig: Nur die Diagonale ist besetzt (7, 4, 4, 4) – alle anderen Felder sind null.
Wer meine Blogs zu Korrelationsmatrizen kennt, erkennt hier ein vertrautes Bild: Normiert man X’X (jeden Wert durch die Wurzel des jeweiligen Diagonalprodukts teilen), entsteht für x₁, x₂ und x₁·x₂ die Einheitsmatrix – keine Korrelation zwischen den Spalten:
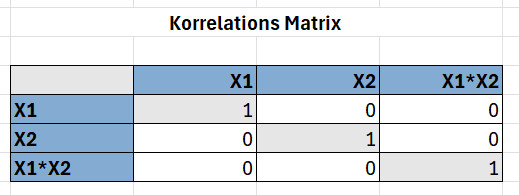
Abbildung 4: Die Korrelationsmatrix bestätigt, was X’X bereits zeigt: x₁, x₂ und x₁·x₂ korrelieren nicht miteinander – Voraussetzung dafür, dass ihre Koeffizienten unabhängig voneinander geschätzt werden können siehe dazu auch Blog zu Korrelationsmatrix/Center-Points.
Eine Diagonalmatrix. Alle Werte außerhalb der Diagonale sind null. Das ist die Orthogonalität des Designs: Weil x₁, x₂ und x₁·x₂ unabhängig voneinander variiert wurden, korrelieren die Spalten nicht miteinander. Die Center Points ändern daran nichts – sie liegen bei (0, 0, 0) und tragen nur zum Achsenabschnitt bei (deshalb die 7 statt 4 in der ersten Zelle).
Der Vorteil: Die Inverse einer Diagonalmatrix ist trivial – man kehrt einfach jeden Diagonalwert um:
(X’X)⁻¹ = diag(1/7, 1/4, 1/4, 1/4)
Kein Gauß-Jordan-Verfahren, keine Zeilenoperationen. Genau das ist der Grund, warum Statistiksoftware intern mit codierten Faktoren rechnet: Ein orthogonales Design macht aus einer aufwendigen Matrixinversion eine einfache Division.
Kurzer Blick zurück: Vor der Matrixrechnung mit kleinsten Quadraten testete man Faktorkombinationen oft über lateinische Quadrate – ein cleveres, aber starres Anordnungsschema ohne echte Fehlerschätzung. Die Regression über kleinste Quadrate löste das ab, weil sie Wechselwirkungen und Vorhersageunsicherheit gleichzeitig quantifizieren kann – lateinische Quadrate konnten das nicht.
Der Rechenweg: b = (X’X)⁻¹ · X’y
Bevor wir rechnen, halten wir fest, woher die Zahlen kommen: y ist einfach die Ergebnisspalte aus Abbildung 2 – in derselben Reihenfolge wie die Versuche in X‘:
y = (912, 848, 768, 672, 805, 795, 800)
X’y entsteht, indem man jede Zeile von X‘ (aus Abbildung 3) Zahl für Zahl mit y multipliziert und die Produkte aufsummiert. Für die Zeile x₁ sieht das ausgeschrieben so aus:
= (−1)·912 + (−1)·848 + (+1)·768 + (+1)·672 + 0·805 + 0·795 + 0·800
= −912 − 848 + 768 + 672
= −320
Die drei Center Points tragen hier nichts bei – ihr x₁-Wert ist ja 0. Für die Zeilen „1″, x₂ und x₁·x₂ läuft dieselbe Rechnung, nur mit den jeweiligen Vorzeichen aus X‘. Die komplette Rechnung von X’y bis zum fertigen Koeffizienten sieht so aus:
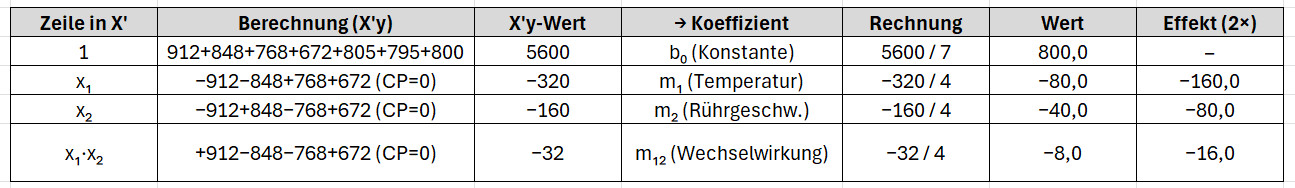
Abbildung 5: Von der Zeile in X‘ über die Berechnung von X’y bis zum fertigen Koeffizienten – und dem daraus verdoppelten Effekt. Die Center Points (CP) tragen bei x₁, x₂ und x₁·x₂ jeweils 0 bei und fallen aus der Rechnung heraus.
Der Ergebnisvektor X’y lautet damit (5600, −320, −160, −32). Jetzt nur noch elementweise mit (X’X)⁻¹ multiplizieren – also jeden Wert durch seinen Diagonalwert (7 bzw. 4) teilen.
Das codierte Modell lautet damit:
y = 800 − 80·x₁ − 40·x₂ − 8·x₁·x₂
Zur Kontrolle: Genau dieselben Werte liefert auch die Software – hier der Koeffizientenplot aus Modde für unser Beispiel:
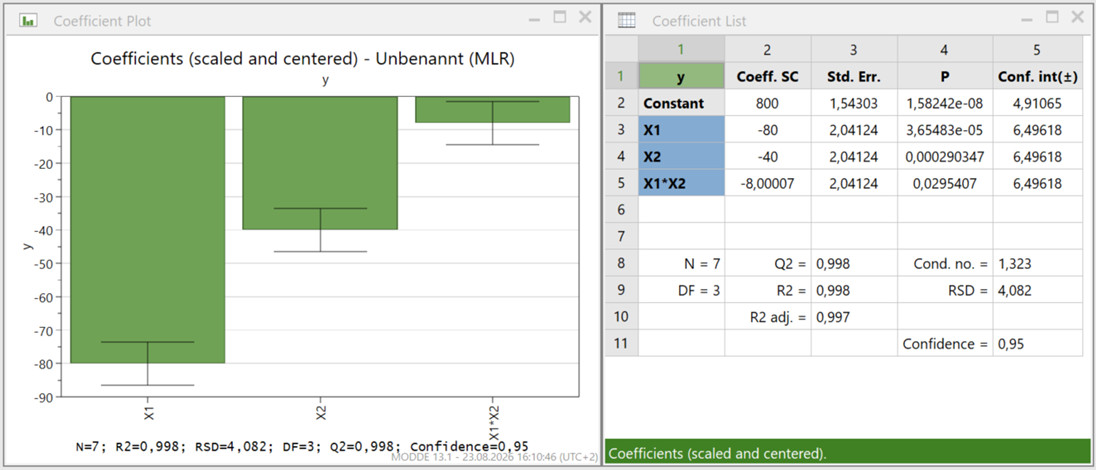
Abbildung 6: Coefficient Plot aus Modde 13.1 – Constant 800, X1 (Temperatur) −80, X2 (Rührgeschwindigkeit) −40, X1·X2 −8. Exakte Übereinstimmung mit unserer Handrechnung. Ein Hinweis zur Ehrlichkeit: R² und Q² liegen hier bei 0,998 – für reale Messdaten ungewöhnlich hoch. Das liegt daran, dass unser Beispiel schematisch konstruiert ist, ganz ohne Messrauschen. In der Praxis dürfen Sie solche Werte nicht erwarten – echte Prozesse streuen.
Und die unkodierte Seite?
Die unkodierte Matrix X’X sähe – mit Werten wie 34.700 oder 392.000 – deutlich weniger freundlich aus. Ihre Spalten korrelieren, eine Inversion von Hand wäre mühsam und fehleranfällig. Genau deshalb geht man diesen Weg in der Praxis nicht: Man rechnet codiert und transformiert anschließend zurück. Mit x₁ = (X₁−70)/10 und x₂ = (X₂−800)/200 ergibt sich nach Einsetzen und Ausmultiplizieren:
y = 1.296 − 4,8·X₁ + 0,08·X₂ − 0,004·X₁·X₂
Auch das bestätigt Modde exakt:
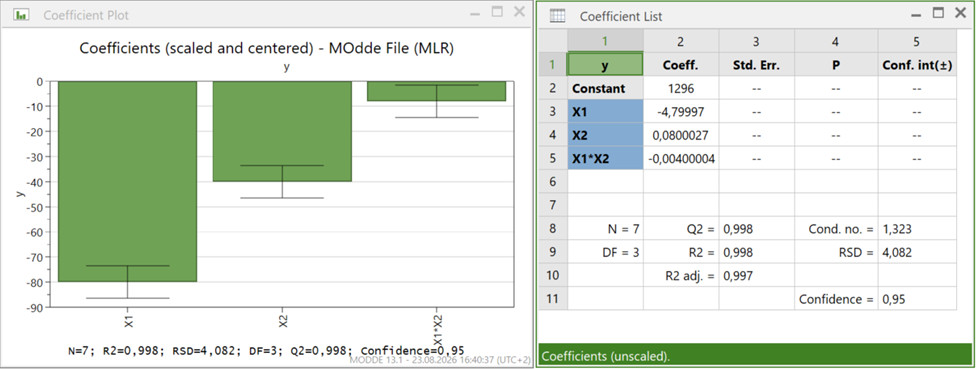
Abbildung 7: Die unskalierten Koeffizienten aus Modde – identisch mit unserer Rücktransformation. Auffällig: keine Standardfehler, keine Konfidenzintervalle. Kein Darstellungsfehler – unskalierte Koeffizienten mischen mehrere codierte Terme, ihre Unsicherheit lässt sich nicht mehr getrennt angeben. Statistische Aussagen bleiben daher Sache des codierten Modells.
Bemerkenswert: Der Rührgeschwindigkeits-Koeffizient wirkt unkodiert (0,08) fast bedeutungslos klein – dabei ist sein codierter Effekt (−80) sogar fünfmal so groß wie der Effekt der Wechselwirkung (−16). Das liegt allein an der Skalierung: U/min bewegt sich in Hunderterschritten, °C in Zehnerschritten.
Unkodierte Koeffizienten sagen nichts über die Wichtigkeit eines Faktors aus – nur codierte Koeffizienten sind direkt vergleichbar.
🔍 Genau deshalb zeigen die meisten Softwarepakete (Modde, Minitab, JMP) standardmäßig die codierten, normalisierten Koeffizienten im Koeffizientenplot an – die unkodierte Form dient meist nur der Prognosegleichung für konkrete Einstellungen.
Ausblick
Mit b₀, m₁, m₂ und m₁₂ vollständig berechnet, folgt in der Praxis die statistische Absicherung: Ist m₁₂ tatsächlich signifikant von null verschieden, oder könnte er auch Zufall sein? Das beantworten ANOVA, t-Test und F-Test – Thema für einen eigenen Artikel.
Und dieses kleine Fundament trägt mehr, als man zunächst denkt: Auch Design Space, PAR/NOR-Auswertungen oder Toleranzauslegung – die eingangs erwähnten Treiber hinter Q8–Q12 – bauen letztlich auf genau diesem Regressionsmodell auf. Für Medizinprodukte gelten davon unabhängige, eigene Normen (z. B. ISO 13485) – nur der Vollständigkeit halber getrennt erwähnt.
Wissen to Go / Fazit
Der Koeffizientenplot in Ihrer DoE-Software ist keine Blackbox. Er ist das Ergebnis einer kleinen, nachvollziehbaren Matrixrechnung – die durch ein orthogonales Design sogar erstaunlich einfach wird. Man muss diese Rechnung im Alltag nicht selbst durchführen. Aber wer sie einmal gesehen hat, liest den nächsten Koeffizientenplot mit anderen Augen.

Und ? … habt Ihr in Eurem Kurs noch die Matrix von Hand rechen dürfen, dann ist der Kurs evtl. so lange her wie bei mir … und eine Auffrischung würde nicht schaden? — Melden Sie oder Du Dich einfach bei mir !
Mehr aus Ihren Prozessen herausholen?
Sie wissen nicht weiter – oder wollen einfach mal gemeinsam auf Ihre Daten schauen? Dann melden Sie sich. Kollegial, unverbindlich, auf Augenhöhe.
Ob DOE-Einstieg oder knifflige Spezialthemen wie Screening, Robustheit, Mischungen oder Troubleshooting – ich begleite Sie praxisnah: mit Trainings, Beratung und methodischer Unterstützung – vom ersten Workshop bis zur Umsetzung.
Auch bei MVDA, DFSS oder QFD stehe ich gern an Ihrer Seite.