DoE-Happen #065Serie: Warum ist mancher Faktoreffekt nicht signifikant?Experte5 Min. Lesezeitaktualisiert am 21.11.2026
Kurz gesagt
Ein Beschichtungsmodell sah überzeugend aus – doch Replicate Plot und Histogramm zeigten zwei Niveaus. Die Ursache war ein mitgeführtes Trocknungsprogramm, das die Haftfestigkeit deutlich verschob. Das Gesamtmodell erklärte vor allem diesen Unterschied. Erst getrennte Modelle je Programm zeigten, welche Stellgrößen innerhalb eines Prozesszustands wirklich tragen.
Im regelmäßigen Qualitätsmeeting stellte die Entwicklung die aktuellen Ergebnisse einer Beschichtungsentwicklung vor. Es ging um die Haftfestigkeit einer funktionalen Schicht auf einem technischen Bauteil.
Ziel war nicht einfach maximale Haftung. Die Haftfestigkeit sollte in einem definierten Bereich liegen: hoch genug, damit die Schicht im Prozess stabil bleibt, aber niedrig genug, damit spätere Funktionen oder Ablöseschritte nicht beeinträchtigt werden.
Was wurde untersucht?
Variiert wurden typische Stellgrößen wie Temperatur, Behandlungszeit, Additivmenge und Primer. Zusätzlich liefen zwei Trocknungsprogramme im Vergleich mit. Beide waren aus Prozesssicht möglich, und man ging davon aus, dass ihr Einfluss eher klein sein würde. Deshalb wurde mit jedem Programm ein vollständiger Versuchssatz inklusive Wiederholungen gefahren. Das Trocknungsprogramm war damit als qualitativer Faktor im Datensatz enthalten.
Auf dem Papier ein sauberer Ansatz: strukturierter Versuchsplan, klare Zielgröße, eingeplante Wiederholungen und eine erste Modellierung, die ordentlich aussah. Im Meeting richtete sich der Blick deshalb schnell auf die geplanten Stellgrößen.
Genau darin lag die spätere Überraschung.
Warum wirkte das Modell so überzeugend?
Das Modell wirkte so, wie man es sich wünscht: stabil genug, vorhersagefähig genug und ohne offensichtlichen Hinweis darauf, dass die Wiederholungen aus dem Ruder laufen. Man hätte leicht sagen können: „Passt doch. Schauen wir auf die wichtigsten Faktoren.“
Auch der Koeffizientenplot zeigte mehrere Einflussgrößen, mit denen man fachlich etwas anfangen konnte. Das Trocknungsprogramm tauchte ebenfalls auf – deutlicher als erwartet. Genau deshalb lohnte sich der zweite Blick.
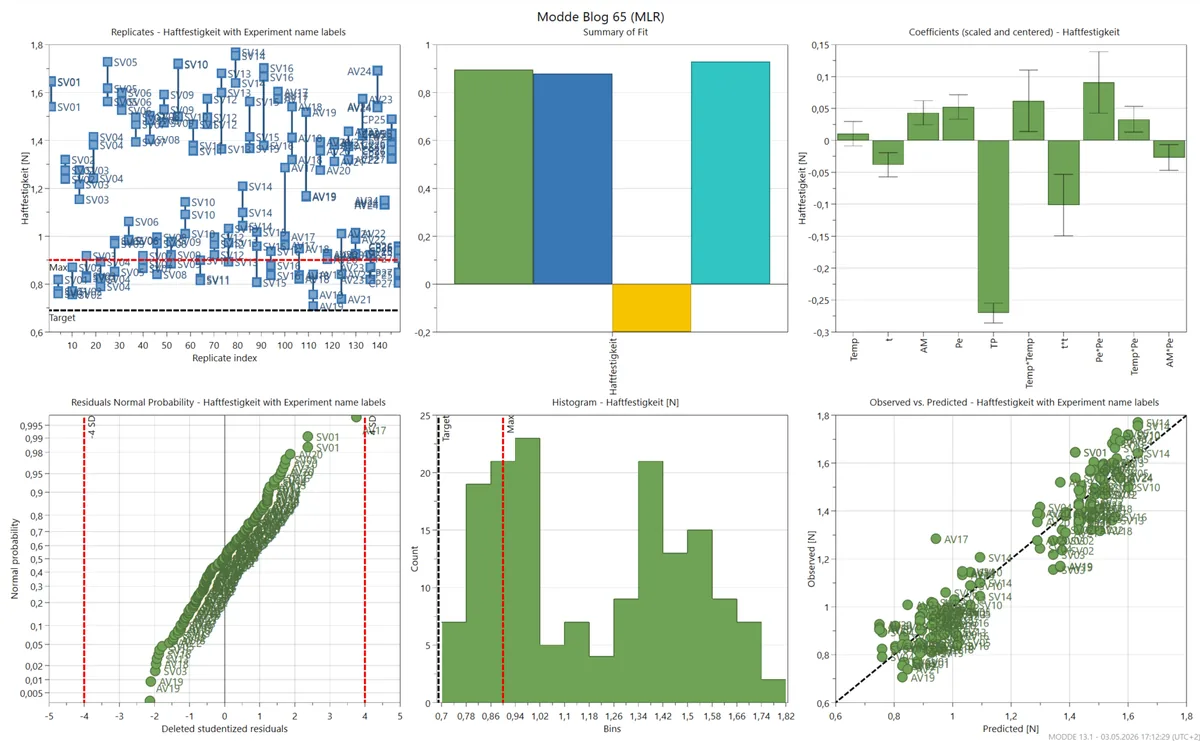
Der Summary Plot vermittelte ein beruhigendes Bild, und der Observed-vs.-Predicted-Plot sah nicht so aus, als würde das Modell an der Realität vorbeirechnen. Nur ein Balken passte nicht ins Bild: Die Modellvalidität war negativ – ein Hinweis darauf, dass dem Modell eine Struktur fehlt.
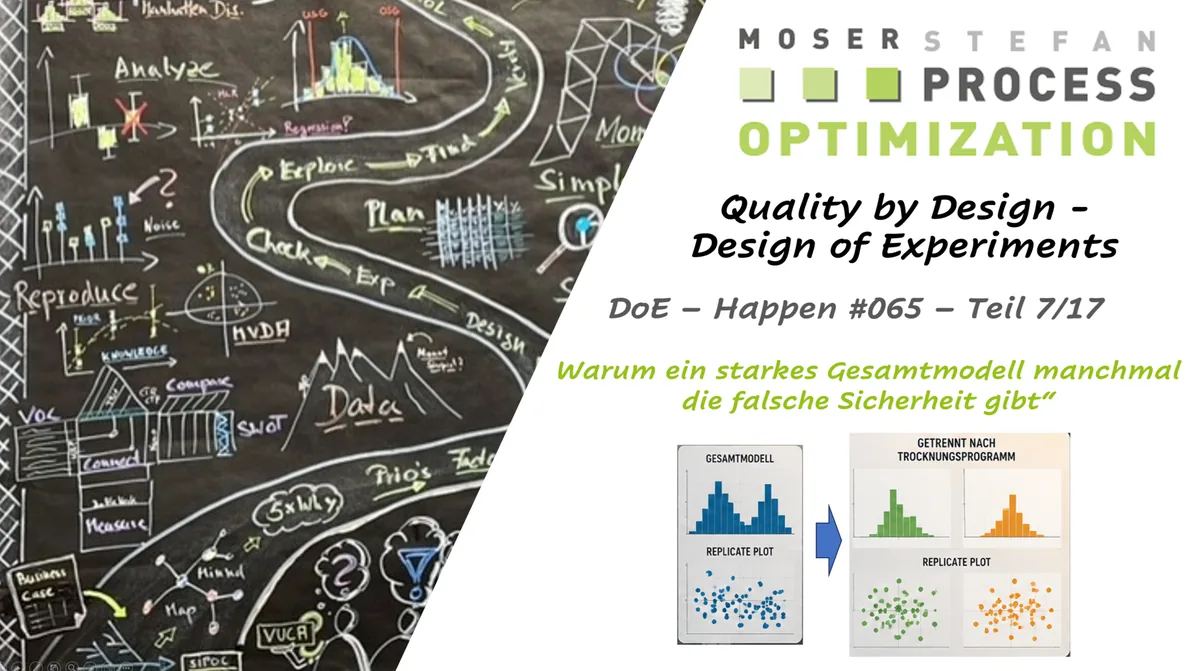
Beim längeren Hinsehen zeigte sich mehr. Im Replicate Plot lagen die Messwerte nicht zufällig verteilt, sondern auf zwei Niveaus: ein Teil nahe am gewünschten Bereich, ein anderer deutlich darüber. Das Histogramm passte dazu – es sah nicht nach einer gemeinsamen Prozesspopulation aus, sondern nach zwei überlagerten Datenwelten.
Das Gesamtmodell sah brauchbar aus. Aber die Rohdaten erzählten eine andere Geschichte.
Erkenntnis
Beschreiben wir hier wirklich einen Prozess – oder vermischen wir zwei Prozesswelten?
Was zeigt die Einfärbung nach Trocknungsprogramm?
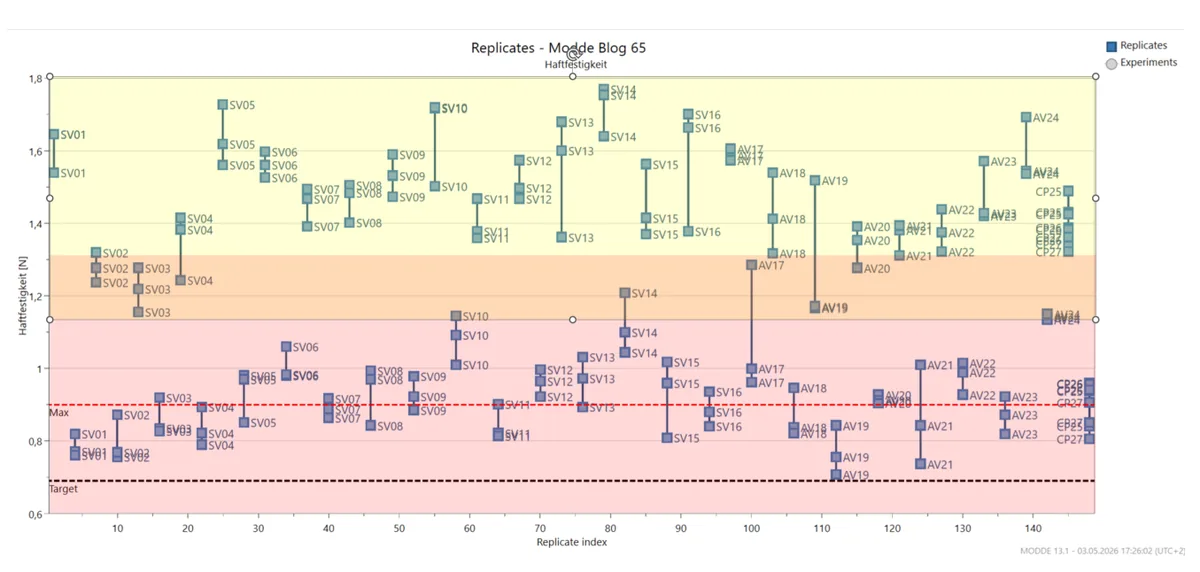
Mit der Einfärbung nach Trocknungsprogramm wurde der Verdacht konkret. Die beiden Gruppen waren nicht vollständig getrennt – das ist in realen Prozessen selten der Fall. Trotzdem war das Muster klar: Ein Programm führte überwiegend zu niedrigeren, das andere zu höheren Haftfestigkeiten.
Gerade die Überschneidung war wichtig. Sie zeigte, dass die geplanten Stellgrößen und die normale Prozessstreuung weiterhin eine Rolle spielten. Aber über allem lag ein deutlicher Niveauunterschied durch das Trocknungsprogramm.
Damit lautete die Frage nicht mehr, ob das Modell gut aussieht, sondern: Wie viel der Modellgüte kommt wirklich aus Temperatur, Behandlungszeit, Additivmenge und Primer – und wie viel aus dem Unterschied zwischen zwei Programmen?
Wenn ein Trocknungsprogramm das Niveau sichtbar verschiebt, nutzt das Gesamtmodell diesen Unterschied – und wirkt dadurch stark. Daraus folgt aber nicht, dass die eigentlichen Stellgrößen innerhalb beider Programme gleich gut verstanden sind.
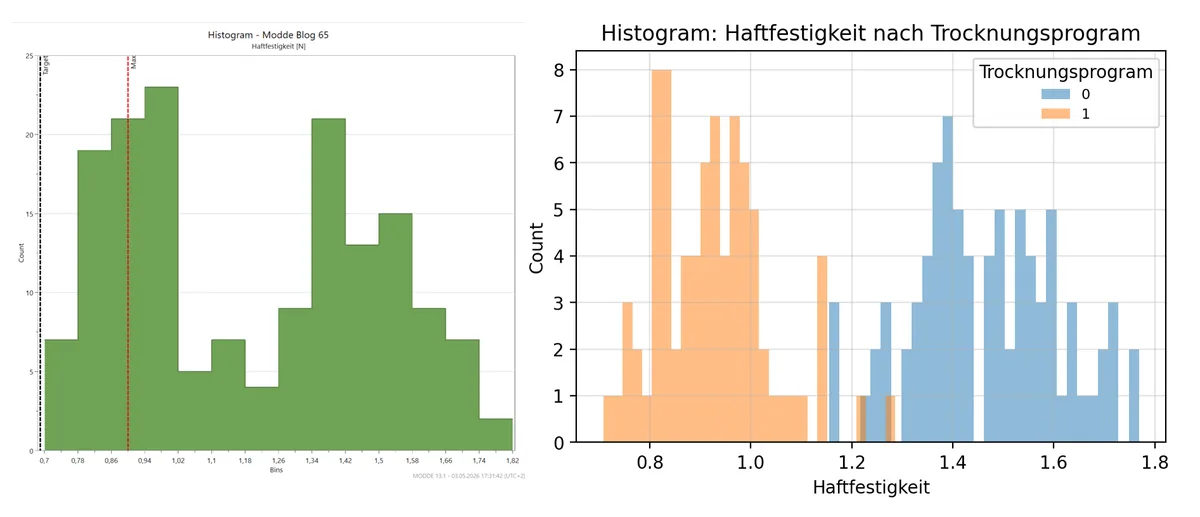
Damit war die Streuung nicht mehr einfach nur „viel Streuung“. Sie bekam eine Richtung.
Warum hilft die nächste Modellrunde hier nicht weiter?
An diesem Punkt hätte man leicht in die nächste Modellrunde springen können: vielleicht fehlt ein Term, vielleicht eine Wechselwirkung. Manchmal ist das richtig. Hier lag der entscheidende Hinweis aber in der Versuchshistorie: Die beiden Trocknungsprogramme waren als praktischer Prozessvergleich mitgelaufen – nicht als Einfluss, der die Auswertung dominieren würde.
Für die Software war es ein gemeinsamer Datensatz. Fachlich waren es zwei Prozesszustände.
Damit wurde verständlich, warum das Gesamtmodell so überzeugend wirkte: Es fand Struktur in den Daten, vor allem über den Hebel des Trocknungsprogramms. Wer den Beschichtungsprozess verstehen will, muss aber eine Ebene tiefer schauen: Welche Rolle spielen die Stellgrößen innerhalb eines Programms?
Deshalb wurden die Daten getrennt betrachtet – je Trocknungsprogramm ein Modell. Und dadurch wurde das Bild ehrlicher.
Was zeigen die getrennten Modelle?
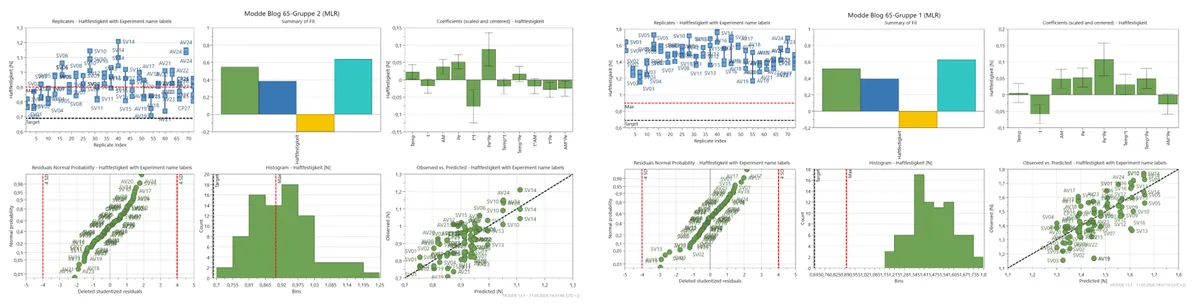
In den getrennten Modellen verschwand die auffällige Zweiteilung. Die Histogramme wirkten nun wie Daten aus jeweils einem Prozesszustand.
Gleichzeitig konnten sich die Einzelmodelle nicht mehr auf den großen Niveauunterschied stützen. Sie mussten innerhalb eines Programms zeigen, welche Rolle Temperatur, Behandlungszeit, Additivmenge und Primer spielen. Dadurch trat hervor, was das Gesamtmodell überdeckt hatte: Innerhalb der Programme überlagerten sich viele Messwerte deutlich. Wiederholstreuung, normale Prozessvariation und unsichere Trends wurden sichtbar.
Einige Zusammenhänge blieben in beiden Einzelmodellen erkennbar, andere wurden schwächer oder verschoben sich. Auch die Modellstruktur war zwischen den Programmen nicht identisch.
Erkenntnis
Das Gesamtmodell konnte zwischen den Programmen unterscheiden. Die Einzelmodelle mussten innerhalb der Programme erklären.
Was bleibt im Gesamtmodell leicht verborgen?
Das Gesamtmodell war nicht wertlos – im Gegenteil. Es zeigte deutlich, dass die Trocknungsprogramme keine kleine Randbedingung waren, sondern das Niveau der Haftfestigkeit spürbar mitprägten. Gefährlich wäre nur gewesen, es als vollständiges Prozessverständnis zu lesen.
Ein Modell, das zwei Gruppen gut auseinanderhält, beantwortet vor allem eine Frage: Welche Gruppe liegt wo? Für die Optimierung reicht das nicht. Dort geht es um die nächste Ebene: Was passiert innerhalb der Gruppe?
Wenn ein Modell gut aussieht, die Rohdaten aber zwei Niveaus zeigen, lohnt sich zuerst eine andere Frage: Welche Prozesszustände stecken in meinen Daten? Das können Programme sein, Chargen, Lagerzeiten, Prüfbedingungen, Schichten oder andere Rahmenbedingungen, die im Alltag selbstverständlich wirken. Sie verschwinden nicht, nur weil sie am Rand des Versuchsplans stehen. Sie wirken trotzdem.
Ein gutes Modell beantwortet immer nur die Frage, die in den Daten sauber gestellt wurde.
Wissen to Go
- Zwei Niveaus im Replicate Plot oder ein zweigipfliges Histogramm: Hinweis auf zwei Prozesszustände im Datensatz.
- Negative Modellvalidität trotz gutem R² und Q²: dem Modell fehlt eine Struktur.
- Erst klären, dann optimieren: Beschreibt das Modell einen Prozess – oder zwei?
- Getrennte Modelle prüfen die Stabilität: Ein Effekt zählt erst, wenn er auch innerhalb eines Prozesszustands trägt.
Häufige Fragen – testen Sie Ihr Wissen
Einsteiger Was bedeutet ein Histogramm mit zwei Gipfeln?
Meist stecken zwei Gruppen in den Daten – etwa zwei Programme, Chargen oder Prüfbedingungen. Die Daten stammen dann nicht aus einem einheitlichen Prozess.
Anwender Warum kann ein gutes R² trotzdem in die Irre führen?
Weil das Modell den großen Unterschied zwischen zwei Gruppen erklärt. Die eigentlichen Stellgrößen innerhalb einer Gruppe können dabei kaum verstanden sein.
Anwender Wann sollte ich getrennte Modelle rechnen?
Wenn ein qualitativer Faktor das Niveau stark verschiebt und Sie wissen wollen, welche Stellgrößen innerhalb eines Prozesszustands wirken. Getrennte Modelle prüfen, ob ein Effekt in beiden Zuständen trägt.
Experte Wie hängen getrennte Modelle und Wechselwirkungen zusammen?
Getrennte Modelle je Programm entsprechen weitgehend einem Gesamtmodell mit Wechselwirkungen zwischen Programm und allen Faktoren – nur mit getrennter Streuungsschätzung. Eine negative Modellvalidität im Gesamtmodell weist oft genau auf diese fehlenden Terme hin.
Passt dazu
- WeiterlesenDoE-Happen #059: Wenn ein Faktor alles dominiert
- DoE-EntscheiderFaktoren-Wirkung